Paginacja stron – jak wpływa na SEO i indeksowanie?
Wchodzisz do kategorii z kilkuset produktami. Zamiast czekać, aż przeglądarka załaduje całą ofertę, widzisz pierwszą część wyników i możesz przejść dalej. To właśnie paginacja stron. Dobrze wdrożona porządkuje rozbudowane listy, ułatwia użytkownikowi orientację i pozwala robotom odkrywać kolejne adresy bez ładowania setek elementów naraz.
Spis treści
- Paginacja stron – co to jest i kiedy ma sens?
- Paginacja a SEO – jak wpływa na indeksację?
- Paginacja a duplicate content – kiedy pojawia się problem?
- Infinite scroll SEO – jak obsłużyć przycisk „pokaż więcej”?
- Crawl budget a paginacja – kiedy liczba adresów staje się problemem?
- Czym różni się paginacja w e-commerce i na blogu?
- Jak wdrożyć paginację poprawnie?
- Checklista wdrożeniowa paginacji
- Podsumowanie
Samo podzielenie listy na strony nie poprawia jednak SEO. Znaczenie ma sposób tworzenia adresów URL, linkowania kolejnych stron, ustawienia canonical oraz obsługa filtrów i treści ładowanej przez JavaScript. Błąd w jednym z tych miejsc może sprawić, że część produktów lub artykułów będzie trudniejsza do znalezienia.
Paginacja stron – co to jest i kiedy ma sens?
Paginacja oznacza podział większego zbioru treści na kolejne adresy URL, na przykład /buty?page=2 i /buty?page=3. Sprawdza się, gdy lista jest na tyle długa, że wyświetlenie wszystkich elementów jednocześnie pogorszyłoby wygodę korzystania ze strony albo jej wydajność. Nie ma natomiast sensu tworzyć 5 podstron dla kilkunastu produktów tylko po to, aby stronicowanie istniało.
Pierwsza strona powinna mieć jedną kanoniczną wersję adresu, np. /buty. Jeśli działa też /buty?page=1, skieruj linki wewnętrzne na wybrany URL. Bezpośrednie wejście na /buty?page=4 musi otwierać czwartą partię produktów, również po odświeżeniu przeglądarki.
Paginacja w sklepie internetowym najczęściej dotyczy kategorii produktowych, wyników wyszukiwania oraz listingów.
Na blogu porządkuje archiwa wpisów, kategorie i tagi. Przykładowo, jeśli w jednej kategorii znajduje się 150 artykułów, a na stronie wyświetla się 10, paginacja dzieli archiwum na 15 podstron. Każda z nich powinna mieć osobny adres URL i zawierać linki prowadzące do konkretnych publikacji. Dzięki temu roboty wyszukiwarek mogą docierać również do starszych tekstów. Trzeba jednak uważać na archiwa kategorii i tagów, które często prezentują te same artykuły w różnych zestawieniach. Może to prowadzić do powstawania wielu podstron o bardzo podobnej zawartości.
W obu przypadkach cel jest podobny, ale konsekwencje SEO są inne. W e-commerce trzeba dodatkowo pilnować filtrów, sortowania i liczby wariantów URL, bo to one potrafią zwielokrotnić liczbę adresów znacznie szybciej niż sama paginacja. Przykładowo kategoria zawierająca 500 par butów może mieć osobne adresy dla kolejnych stron listingu, wybranych rozmiarów, kolorów, marek i sposobów sortowania. Połączenie kilku parametrów, np. ?color=black&size=42&sort=price&page=2, tworzy następne warianty URL. W rezultacie roboty mogą odwiedzać setki adresów wyświetlających podobne zestawy produktów. Zwiększa to obciążenie związane z crawlowaniem i może ograniczać częstotliwość odwiedzania ważniejszych podstron sklepu. Dlatego warto ustalić, które kombinacje filtrów mają znaczenie dla SEO, a które powinny pozostać poza indeksem lub zostać wyłączone z crawlowania.
Paginacja a SEO – jak wpływa na indeksację?
Paginacja a indeksacja są ze sobą bezpośrednio powiązane, bo Google traktuje strony paginacji jako osobne adresy URL. Dobrze przygotowana paginacja SEO daje każdej z nich własny, stały adres i linki HTML prowadzące do kolejnych części listy. Najbezpieczniejszy wzorzec to zwykłe elementy <a href>, ponieważ crawler może je odkryć bez wykonywania dodatkowej akcji w interfejsie.
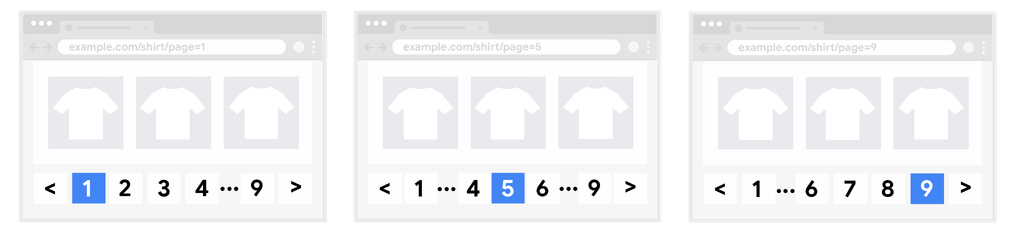
Zdj. 1. Przykład klasycznej paginacji stron. Źródło: Google Search Central
Canonical na paginacji powinien wskazywać na aktualną stronę, a nie zawsze na stronę pierwszą. Dla /kategoria?page=2 canonical powinien więc prowadzić do /kategoria?page=2. Kierowanie wszystkich stron na stronę pierwszą sugeruje, że dalsze części są jej duplikatami, choć zawierają inny zestaw produktów lub wpisów.
Self-referencing canonical wskazuje Google preferowany adres URL, jednak ostateczną decyzję podejmuje wyszukiwarka. Jeśli kolejne strony paginacji mają niemal identyczną zawartość, Google może wybrać inny adres kanoniczny. Dlatego zadbaj, aby każda część listy prezentowała odrębny zestaw produktów. Więcej o canonical w dokumentacji Google.
Nie ma też potrzeby stosować noindex na paginacji tylko dlatego, że jest to 2., 3. czy 10. strona listy. Jeśli te adresy są potrzebne do odkrywania elementów położonych głębiej, pozostaw je dostępne do crawlowania i co do zasady bez dyrektywy noindex. Długotrwałe wykluczenie stron z indeksowania ogranicza sens traktowania ich jako stałej ścieżki odkrywania produktów.
Google zrezygnował z wykorzystywania atrybutów rel=”next” i rel=”prev” do rozpoznawania paginacji. Możesz pozostawić je w istniejącym kodzie, jednak ich obecność ma obecnie drugorzędne znaczenie dla SEO. Wyszukiwarka rozpoznaje kolejne strony sekwencji przede wszystkim na podstawie odrębnych adresów URL i prowadzących do nich linków HTML.
Sam znacznik <link rel=”next”> w sekcji <head> nie zastąpi linku „Następna” w HTML. Google potwierdza, że nie wykorzystuje już tych oznaczeń.
Paginacja a duplicate content – kiedy pojawia się problem?
Kolejne strony paginacji zazwyczaj wyświetlają inne produkty, dlatego Google traktuje je jako odrębne podstrony. Problem duplikacji treści może pojawić się jednak wtedy, gdy na każdej z nich powtarza się ten sam rozbudowany opis kategorii. Z kolei identyczne nagłówki, elementy szablonu czy podobne meta tagi są typowe dla paginacji i same w sobie nie oznaczają problemu z duplicate content.
Opis kategorii najlepiej pozostawić na pierwszej stronie listingu, szczególnie gdy jest rozbudowany i przygotowany pod zapytania użytkowników. Powielanie go na każdej kolejnej stronie nie wnosi nowej informacji i może pogarszać odbiór listingu. Nie trzeba tworzyć sztucznie nowych opisów tylko po to, aby każda podstrona różniła się tekstem.
Google dopuszcza takie same title i description na stronach jednej sekwencji. Jeśli chcesz ułatwić użytkownikowi orientację, możesz dodać numer strony do title, ale nie jest to warunek poprawnej paginacji SEO.
Przykładowy title to „Buty trekkingowe – strona 3”. Numer ułatwia orientację, choć Google dopuszcza powtarzające się meta tagi w sekwencji. Istotniejsze jest to, czy strony prezentują różne elementy.
Infinite scroll SEO – jak obsłużyć przycisk „pokaż więcej”?
Infinite scroll oraz przycisk „pokaż więcej” mogą być wygodniejsze od klasycznej paginacji, ale tylko wtedy, gdy pod spodem nadal istnieją adresy URL możliwe do odkrycia przez crawlera. Google nie klika przycisków po to, aby odsłonić kolejne produkty. Jeżeli następna partia wyników pojawia się dopiero po akcji użytkownika i nie ma osobnego adresu dostępnego przez link HTML, część listy może pozostać niewykryta.
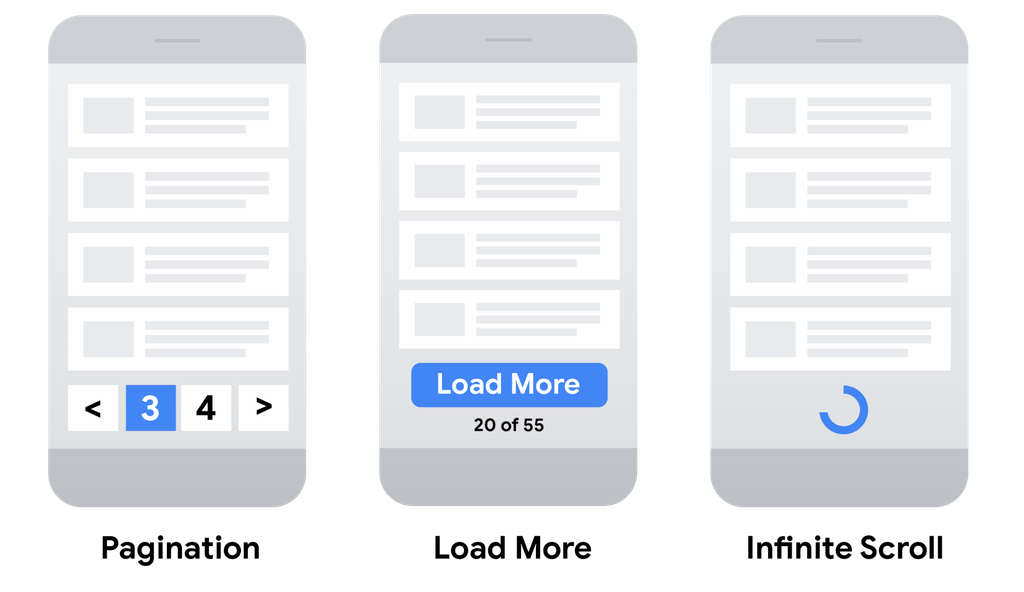
Zdj. 2. Porównanie Pagination vs Load More vs Infinite Scroll. Źródło: Google Search Central
Przy infinite scroll SEO warto więc zachować paginowane adresy dla kolejnych fragmentów, a po przewinięciu do nowej części aktualizować URL za pomocą History API. Adres nie powinien bazować na fragmencie po znaku #. Każdy fragment listy musi być dostępny bez konieczności przewinięcia wcześniejszych kilkuset wyników.
Aktualizuj URL, gdy kolejna partia staje się główną widoczną zawartością, np. po wykryciu jej za pomocą IntersectionObserver. Obsłuż odświeżanie, udostępnianie adresu oraz przejścia „wstecz” i „dalej”.
Podobnie działa przycisk „pokaż więcej”. Może zostać w interfejsie, ale kolejne partie powinny mieć swoje adresy URL i być połączone linkami. Opcja „pokaż wszystko” ma sens przy mniejszych zbiorach, gdy pełna lista nie obciąża strony. Nie warto jednak tworzyć ciężkiej strony ze wszystkimi produktami tylko po to, aby ustawić ją jako canonical dla całej paginacji.
Wariant „pokaż wszystko” przetestuj na telefonie: sprawdź czas ładowania i liczbę pobieranych danych. Przy tysiącach produktów pełna lista może obciążać przeglądarkę. Nie rezygnuj z odrębnych adresów paginacji, jeżeli są potrzebne robotom do odkrywania produktów.
Treść ładowana dopiero po kliknięciu lub wykonaniu skryptu to także ryzyko poza Google. Nie należy zakładać, że crawler wykorzystywany przez system AI wykona te same interakcje co przeglądarka użytkownika. Ważne produkty, nagłówki i opisy powinny mieć stabilny adres oraz być dostępne dla bota bez dodatkowych barier.
Boty AI różnią się sposobem pobierania stron, dlatego nie należy zakładać, że renderują JavaScript tak jak Google. OpenAI rozróżnia OAI-SearchBot, używany do wyszukiwania w ChatGPT, oraz GPTBot, związany z pozyskiwaniem danych do trenowania. Dokumentacja OpenAI nie gwarantuje wykonywania przez te boty skryptów ani interakcji z przyciskami. Sprawdzaj więc linki w HTML zwracanym przez serwer, ustawienia robots.txt i logi konkretnych crawlerów.
Crawl budget a paginacja – kiedy liczba adresów staje się problemem?
Sama paginacja rzadko jest największym problemem dla crawl budgetu. Większe ryzyko pojawia się wtedy, gdy łączy się z filtrowaniem i sortowaniem. Jedna kategoria może wtedy generować setki kombinacji w rodzaju ?color=black, ?size=42, ?sort=price i ich połączeń, a crawler zaczyna odwiedzać adresy, które nie mają znaczenia w wyszukiwarce.
W dużym e-commerce trzeba oddzielić adresy paginacji od parametrów filtrów. Strony ?page=2 czy ?page=3 mogą być potrzebne do odkrywania produktów, podczas gdy część wariantów filtrowanych lepiej ograniczyć przed crawlowaniem lub indeksowaniem.
Jeśli chcesz wykluczyć stronę z wyników wyszukiwania, zastosuj noindex, umożliwiając robotowi jej pobranie. robots.txt ogranicza crawlowanie, ale nie gwarantuje usunięcia URL-a z indeksu: Google może znać adres z linków i wyświetlić go bez opisu. Nie blokuj w robots.txt strony, z której robot ma odczytać noindex.
Znaczenie ma również linkowanie wewnętrzne. Nie warto tworzyć sekwencji, w której crawler może dotrzeć do strony 20 wyłącznie po dziewiętnastu kolejnych kliknięciach. Linki do sąsiednich stron, wybranych numerów oraz strony pierwszej skracają drogę do głębszych części listy i ułatwiają użytkownikowi powrót.
Nie musisz linkować do wszystkich numerów stron. Zadbaj o nawigację i linki do ważnych produktów. Crawl budget wymaga osobnej uwagi przede wszystkim w dużych lub często aktualizowanych serwisach, a nie na niewielkim blogu.
Czym różni się paginacja w e-commerce i na blogu?
W sklepie internetowym priorytetem jest odkrywanie produktów oraz kontrola filtrów. Strony paginacji powinny prowadzić do kart produktów za pomocą zwykłych linków HTML, a kombinacje sortowania i filtrów wymagają osobnej strategii. W przeciwnym razie dobrze wdrożona paginacja może zostać przykryta przez tysiące technicznych wariantów URL.
Warto też zwrócić uwagę na wyniki wyszukiwania w sklepie. Każde zapytanie wpisane przez użytkownika może tworzyć osobny adres URL, np. /szukaj?q=buty. W dużym sklepie takich adresów mogą być tysiące, choć wiele z nich ma niewielką wartość dla SEO. Dlatego zwykle warto wykluczyć je z indeksu Google za pomocą dyrektywy noindex. Aby Google mógł ją odczytać, strona musi pozostać dostępna dla jego robotów. Zasada ta dotyczy wyników wyszukiwania wewnętrznego, a nie standardowych kategorii produktów.
Na blogu paginacja służy przede wszystkim do porządkowania artykułów. Ważne, aby roboty Google mogły łatwo dotrzeć także do starszych wpisów. Pomagają w tym kategorie, tagi oraz linki prowadzące do powiązanych tekstów. W WordPressie kolejne strony archiwum mają zwykle adresy takie jak /page/2/. Warto sprawdzić, czy każda z nich ma własny canonical i czy wtyczka SEO lub motyw przypadkowo nie blokuje jej indeksowania za pomocą noindex.
Po zmianie motywu, wtyczki SEO lub cache sprawdź adresy /page/2/ i ostatniej strony archiwum. Powinny wyświetlać odrębne wpisy i kod 200. Jeśli archiwum kończy się na /page/8/, kolejny numer powinien zwrócić 404, a nie pustą listę z kodem 200.
Prawidłowo wdrożona paginacja ułatwia poruszanie się po stronie i wspiera SEO. Problemy pojawiają się wtedy, gdy kolejne części listy są dostępne dopiero po uruchomieniu JavaScriptu, wszystkie mają canonical prowadzący do pierwszej strony lub filtry generują tysiące zbędnych adresów URL. Dlatego warto zadbać o poprawne linkowanie, osobne adresy dla kolejnych stron i odpowiednie ustawienia indeksowania. Dzięki temu roboty wyszukiwarek mogą łatwiej docierać do wszystkich produktów i artykułów w serwisie.
Czy Google dociera do wszystkich produktów w Twoim sklepie?
Jak wdrożyć paginację poprawnie?
Aby prawidłowo wdrożyć paginację, zadbaj o trzy podstawowe elementy: osobny adres URL dla każdej części listy, linki HTML prowadzące do kolejnych stron oraz poprawne ustawienia canonical. Dzięki temu roboty wyszukiwarek mogą łatwo odnajdywać kolejne podstrony i rozpoznawać ich zawartość.
W Google Search Console użyj „Sprawdzenia adresu URL” dla kilku stron paginacji. Porównaj ich kod źródłowy i renderowany HTML, skontroluj wybrany canonical oraz linki do kolejnych stron i produktów. W rozbudowanym sklepie przeanalizuj dodatkowo logi serwera.
Przykład linkowania kolejnych stron
<a href=”/kategoria”>1</a>
<a href=”/kategoria?page=2″>2</a>
<a href=”/kategoria?page=3″>3</a>
Przykład self-referencing canonical na drugiej stronie
<link rel=”canonical” href=”https://example.com/kategoria?page=2″>
Przykład użycia History API
history.replaceState({page: 3}, „”, „/kategoria?page=3”);
To wyłącznie aktualizacja URL. Wywołaj ją, gdy trzecia partia staje się główną widoczną zawartością. Osobno obsłuż wejście bezpośrednio na ten adres, odświeżenie oraz przyciski „wstecz” i „dalej”. Jeśli użytkownik ma wracać do poprzednich partii, rozważ pushState.
Checklista wdrożeniowa paginacji
Przed wdrożeniem sprawdź jeszcze kilka elementów.
- Każda strona paginacji ma unikalny i stabilny URL.
- Canonical wskazuje na aktualny adres strony.
- Kolejne części listy są połączone linkami <a href>.
- Standardowa paginacja nie ma automatycznie ustawionego noindex.
- Filtry i sortowanie są obsługiwane niezależnie od stron ?page=.
- Infinite scroll lub pokaż więcej mają crawlable odpowiedniki URL.
- History API aktualizuje adres, gdy użytkownik przechodzi do kolejnego fragmentu listy.
- Produkty i wpisy nie są dostępne wyłącznie po wykonaniu akcji JavaScript.
- Nieistniejące numery stron zwracają 404 zamiast pustej listy.
- Nie ma przypadkowego blokowania zwykłych stron paginacji w robots.txt.
- Wyniki wyszukiwarki wewnętrznej mają odrębne zasady indeksowania.
- Po odświeżeniu lub otwarciu linku udostępnionego z infinite scroll wyświetla się odpowiedni fragment listy.
- Sprawdzono statusy HTTP, canonical i linki w Search Console.
Podsumowanie
Im większy serwis, tym więcej szkód może wyrządzić źle wdrożona paginacja. Produkty ukryte na dalszych stronach kategorii mogą pozostawać poza zasięgiem robotów Google, a tysiące zbędnych adresów generowanych przez filtry utrudniają sprawne indeksowanie witryny. W efekcie nawet atrakcyjna oferta czy wartościowe artykuły mogą mieć problem z dotarciem do użytkowników.
Dlatego warto regularnie sprawdzać, czy kolejne strony są dostępne dla wyszukiwarek, mają poprawne adresy canonical i prowadzą do nich działające linki. Zacznij od audytu kilku najważniejszych kategorii i sprawdź, czy Google rzeczywiście dociera do ich dalszych stron. Czasem wystarczy poprawić sposób linkowania lub ustawienia indeksowania, aby ułatwić wyszukiwarce odkrywanie treści, które od dawna znajdują się w Twoim serwisie.
FAQ
-
Co to jest paginacja stron?
Paginacja to podział długiej listy produktów, artykułów lub wyników na kolejne strony z osobnymi adresami URL. Ułatwia nawigację i pozwala użytkownikom oraz robotom wyszukiwarek docierać do dalszych elementów listy.
-
Czy paginacja wpływa na SEO?
Tak, prawidłowo wdrożona paginacja pomaga Google odkrywać produkty i artykuły. Niepoprawne linkowanie, ustawienia canonical lub blokowanie kolejnych stron mogą ograniczać dostępność treści dla robotów.
-
Jak ustawić canonical na stronach paginacji?
Co do zasady każda strona paginacji powinna wskazywać własny adres kanoniczny. Przykładowo
/kategoria?page=2powinien mieć canonical prowadzący do tego samego URL, a nie automatycznie do pierwszej strony kategorii. -
Czy strony paginacji powinny mieć noindex?
Nie należy automatycznie stosować noindex na kolejnych stronach paginacji. Jeśli pomagają robotom odkrywać produkty lub artykuły, powinny co do zasady pozostać dostępne do crawlowania i indeksowania.
Źródła:
developers.google.comza strona kategorii.