Renderowanie strony internetowej – na czym polega?
Renderowanie strony internetowej to zamiana plików, które serwer wysyła do przeglądarki, w stronę widoczną na ekranie. Od tego, czy pracę tę wykonuje serwer, czy urządzenie użytkownika, zależy, jaką wersję treści dostaje Googlebot i jaka jej część trafia do wyników wyszukiwania.…
Spis treści
- Co to jest renderowanie strony internetowej?
- Jakie pliki przeglądarka dostaje z serwera?
- Co to znaczy, że przeglądarka buduje stronę?
- Czym różni się kod źródłowy strony od DOM?
- Jak Googlebot renderuje strony internetowe?
- Czym renderowanie w Google różni się od zwykłej wizyty użytkownika?
- Czym różnią się CSR, SSR i SSG?
- Jakie problemy z renderowaniem strony występują w Google i jak je rozwiązać?
- Jak renderowanie strony wpływa na Core Web Vitals?
- Jak sprawdzić renderowanie strony w Google Search Console?
- Podsumowanie
Renderowanie strony internetowej to zamiana plików, które serwer wysyła do przeglądarki, w stronę widoczną na ekranie. Od tego, czy pracę tę wykonuje serwer, czy urządzenie użytkownika, zależy, jaką wersję treści dostaje Googlebot i jaka jej część trafia do wyników wyszukiwania. Zobacz, jak wygląda ten proces od środka.
Co to jest renderowanie strony internetowej?
Renderowanie strony internetowej to wykonanie kodu tej strony i ułożenie z niego dokumentu, który widzisz na ekranie: z nagłówkami i akapitami na swoich miejscach, obrazkami w swoich rozmiarach i działającymi przyciskami.
Strona internetowa znajduje się na serwerze jako zestaw plików tekstowych, które opisują, co ma się pojawić na ekranie. Kiedy wpisujesz adres, przeglądarka wysyła do serwera żądanie, serwer odsyła pliki strony, a przeglądarka odczytuje je i rysuje z nich stronę. Ten ostatni krok to właśnie renderowanie.
Ciekawostka!
Samo słowo „renderowanie” funkcjonuje także w grafice komputerowej i w obróbce wideo, gdzie oznacza wyliczanie obrazu z modelu albo z projektu montażowego. W SEO renderowanie strony internetowej oznacza wykonanie jej kodu i to ono rozstrzyga, którą wersję treści widzi wyszukiwarka.
Jakie pliki przeglądarka dostaje z serwera?
Typowa strona internetowa składa się z trzech rodzajów kodu i każdy odpowiada za co innego:
- HTML – treść i jej struktura. Zawiera słowa, które czytasz, oraz informację, czym każdy fragment jest: tytułem, nagłówkiem, akapitem, pozycją listy, linkiem czy obrazkiem.
- CSS – wygląd. Opisuje kolor tekstu, krój i wielkość liter, szerokość kolumn, odstępy oraz tło.
- JavaScript – działanie. Reaguje na kliknięcia, pobiera dane z serwera po otwarciu strony i dopisuje do niej kolejne fragmenty: listę produktów, opinie klientów, wynik wyszukiwarki wewnętrznej.
Wszystkie 3 rodzaje kodu przeglądarka dostaje jako zwykły tekst. Każdy z tych plików zawiera wyłącznie instrukcje, a obraz strony powstaje dopiero z ich wykonania.
Co to znaczy, że przeglądarka buduje stronę?
Budowanie strony to seria kroków, w których przeglądarka zamienia tekst kodu w ułożony i pokolorowany obraz na ekranie. Jak to przebiega?
- Odczytanie HTML i budowa DOM. Przeglądarka czyta kod HTML znak po znaku i zapisuje w pamięci spis wszystkich elementów strony: nagłówków, akapitów, obrazków, linków. Spis ma budowę drzewa, bo akapit należy do sekcji, a sekcja do dokumentu. Ta struktura nazywa się DOM (Document Object Model) i w niej strona żyje przez cały czas, gdy użytkownik ma ją otwartą.
- Odczytanie CSS i budowa CSSOM. Przeglądarka czyta arkusze stylów i ustala, jak każdy element ze spisu ma wyglądać. Powstaje druga struktura, CSSOM (CSS Object Model), z kolorami, rozmiarami i odstępami.
- Połączenie obu struktur. Przeglądarka zestawia spis elementów z ich wyglądem i zachowuje te, które mają pojawić się na ekranie.
- Obliczenie układu. Przeglądarka wylicza w pikselach, gdzie stoi każdy element i ile zajmuje miejsca. Ten sam akapit wypada inaczej na telefonie, a inaczej na monitorze.
- Malowanie i złożenie obrazu. Przeglądarka rysuje piksele i składa je w gotowy obraz strony. Pracuje warstwami, więc zmiana jednego elementu wymaga przerysowania jednej warstwy.
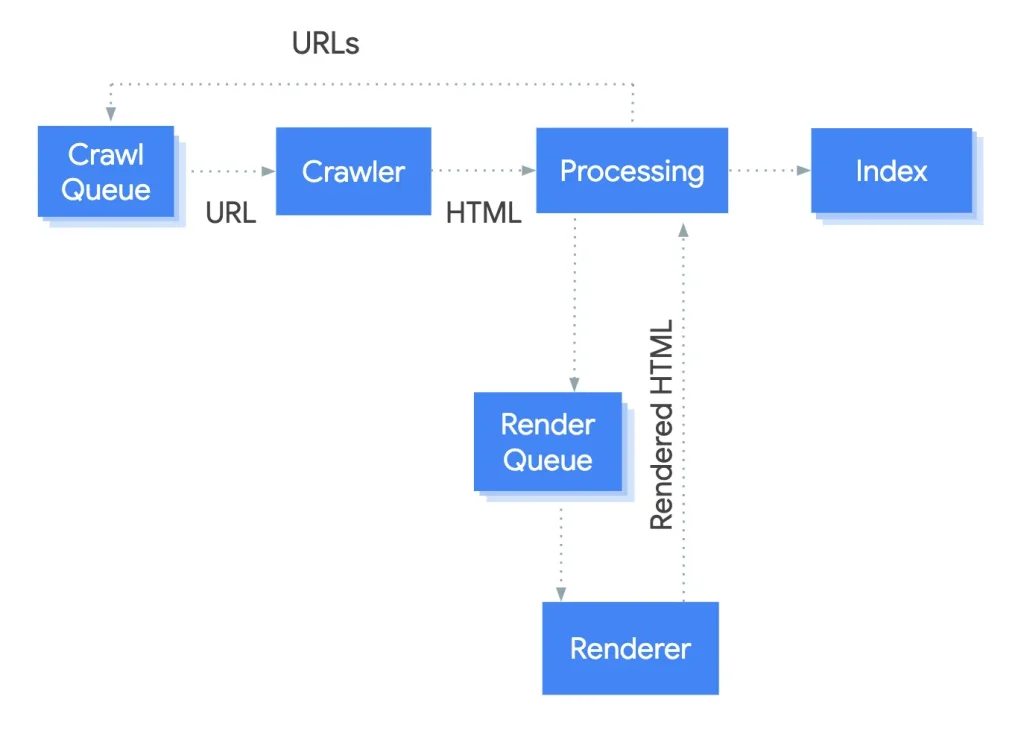
Zdj. 1. Proces przetwarzania strony internetowej przez Google. Źródło: developers.google.com
Cała ta seria trwa ułamki sekundy i powtarza się, gdy coś na stronie się zmienia. Jeżeli JavaScript dopisuje treść po pierwszym wyświetleniu, przeglądarka ponownie wylicza układ i maluje obraz, a każde powtórzenie zajmuje główny wątek – jedyną ścieżkę, na której przeglądarka wykonuje skrypty i rysuje stronę. Stąd opóźniona reakcja na kliknięcie i treść przeskakująca pod palcem.
Czym różni się kod źródłowy strony od DOM?
Kod źródłowy strony to wersja przesłana przez serwer, natomiast DOM pokazuje jej aktualną strukturę, uwzględniając również treści dodane przez JavaScript. Różnica między nimi ma znaczenie dla SEO. Jeśli nagłówki, opisy produktów czy artykuły pojawiają się dopiero po uruchomieniu skryptów, Googlebot musi je wykonać, aby odczytać te treści. Jeśli renderowanie się nie powiedzie, część zawartości strony może zostać pominięta podczas indeksowania.
Kod źródłowy możesz podglądnąć, wybierając opcję „pokaż źródło strony” (Ctrl+U, a na macOS Cmd+Option+U), a DOM – w narzędziach deweloperskich, w zakładce z elementami strony. Na stronach zbudowanych we frameworkach takich jak React czy Vue w kodzie źródłowym stoi pusty kontener i odwołania do skryptów, a cała treść pojawia się w DOM. Dla robota, który poprzestaje na kodzie źródłowym, taka strona jest pusta.
Jak Googlebot renderuje strony internetowe?
Google przetwarza każdą stronę w 3 rozdzielonych w czasie etapach:
- Pobieranie (crawling) – Googlebot, program pobierający strony na potrzeby wyszukiwarki, zachowuje się jak przeglądarka: wysyła żądanie pod adres URL i odbiera pliki strony. Odczytuje następnie jej kod źródłowy i kieruje stronę do kolejnego etapu.
- Renderowanie – strona czeka w kolejce, a kiedy przyjdzie jej pora, przeglądarka Chromium w trybie headless, czyli pracująca w tle i składająca stronę wyłącznie w pamięci serwera, wykonuje JavaScript strony i zwraca gotowy dokument [1].
- Indeksowanie – Google zapisuje treść z gotowego dokumentu w indeksie, czyli bazie, z której wyszukiwarka układa wyniki. Z tego samego dokumentu wybiera też kolejne adresy do odwiedzenia.
Google wskazuje, że strona może czekać w kolejce kilka sekund, a czasem dłużej [1]. Renderowanie pochłania moc obliczeniową serwerów, więc w katalogach produktowych czy portalach ogłoszeniowych, gdzie adresów są dziesiątki tysięcy, oczekiwanie w kolejce wydłuża aktualizację indeksu.
Czym renderowanie w Google różni się od zwykłej wizyty użytkownika?
Google renderuje strony za pomocą Web Rendering Service (WRS), który korzysta z aktualnej wersji Chromium, czyli silnika używanego w przeglądarce Chrome. Dzięki temu może wykonywać JavaScript i odczytywać treści dodawane przez skrypty. Nie działa jednak dokładnie tak, jak przeglądarka zwykłego użytkownika. Różnice dotyczą czterech obszarów [2]:
- WRS zaczyna każde wczytanie strony od pustego stanu. Dane zapamiętane w przeglądarce – pliki cookie oraz zawartość Local Storage i Session Storage – są czyszczone przy każdym adresie, więc treść widoczna wyłącznie dla powracającego użytkownika zostaje pominięta: widok po zalogowaniu, wybór kraju i waluty, baner z drugiej wizyty.
- WRS odmawia dostępu do lokalizacji, kamery i mikrofonu. Strona, która pokazuje treść po zgodzie na geolokalizację, dla Google pozostaje pusta. Przewidź w kodzie wersję na tę odmowę: pełną listę oddziałów z polem do wpisania miasta.
- WRS przechowuje pliki strony dłużej niż przeglądarka użytkownika. Czasem sięga po starszą wersję pliku JS lub CSS, choć na serwerze stoi już nowa. Rozwiązaniem jest odcisk treści w nazwie pliku, np. main.2bb85551.js: ciąg wyliczony z zawartości zmienia się po każdej poprawce kodu, więc WRS pobiera nową wersję.
- WRS renderuje stronę w bardzo wysokim oknie. Treść doładowywana po przewinięciu zostaje pominięta, bo zdarzenie przewijania pada przy faktycznym przesunięciu okna. Leniwe ładowanie obrazów oprzyj na mechanizmie IntersectionObserver, który reaguje na pojawienie się elementu w polu widzenia [3].
Google wykonuje JavaScript, a mimo to indeksowanie stron opartych na JavaScripcie zawsze oznacza dodatkowe ryzyko i opóźnienie – ten obszar optymalizacji branża nazywa JavaScript SEO. Treść z kodu źródłowego trafia do indeksowania z pominięciem etapu renderowania.
Czym różnią się CSR, SSR i SSG?
Skoro kod strony ktoś musi wykonać, pozostaje pytanie, kto i kiedy. Pracę tę może wziąć na siebie przeglądarka użytkownika, serwer przy każdym żądaniu albo generator uruchamiany podczas budowania serwisu – i właśnie te odpowiedzi kryją się za skrótami CSR, SSR i SSG.
Na czym polega client-side rendering (CSR)?
Client-side rendering (CSR), czyli renderowanie po stronie klienta, przenosi pracę na urządzenie użytkownika. Serwer odsyła minimalny plik HTML: pusty kontener i odwołanie do paczki JavaScriptu, czyli pliku z całym kodem aplikacji. Przeglądarka pobiera skrypty, wykonuje je, pobiera dane z serwera i dopiero wtedy układa treść strony.
Tak działa domyślnie aplikacja jednostronicowa (SPA, single-page application): serwis ma jeden wczytany dokument, a skrypt podmienia w nim kolejne widoki.
CSR dobrze sprawdza się w panelach klienta i koszykach zakupowych, gdzie użytkownik wykonuje wiele działań bez konieczności ponownego wczytywania całej strony. Wadą tego rozwiązania jest dłuższy czas oczekiwania na pierwsze wyświetlenie treści. Jeśli JavaScript nie zadziała prawidłowo, część strony może pozostać niewidoczna.
Na czym polega server-side rendering (SSR)?
Server-side rendering (SSR), czyli renderowanie po stronie serwera, przenosi pracę na serwer. Układa on pełny HTML osobno dla każdego żądania i odsyła gotowy dokument, który przeglądarka wyświetla od razu. Następnie przeglądarka uruchamia JavaScript, który dodaje do strony funkcje interaktywne, np. obsługę przycisków i formularzy. Proces ten nazywa się hydracją (hydration).
Ponieważ treść strony znajduje się już w kodzie HTML przesłanym przez serwer, Google może ją odczytać bez konieczności wykonywania JavaScriptu. Takie rozwiązanie zwiększa jednak obciążenie serwera i może wydłużyć TTFB (Time to First Byte), czyli czas oczekiwania na pierwszy bajt odpowiedzi. Dodatkowo podczas hydracji przeglądarka musi przetworzyć gotowy dokument i uruchomić funkcje interaktywne, co obciąża urządzenie użytkownika.
Na czym polega static site generation (SSG)?
Static site generation (SSG), czyli generowanie statyczne, polega na przygotowaniu gotowych stron HTML jeszcze przed ich odwiedzeniem przez użytkownika. Pliki powstają podczas budowania serwisu i są przechowywane na serwerze lub w sieci CDN (Content Delivery Network). Jest to sieć serwerów rozmieszczonych w różnych lokalizacjach, dzięki której użytkownik może pobrać stronę z najbliższego dostępnego serwera. Ponieważ plik HTML jest już gotowy, serwer nie musi generować go przy każdym żądaniu, co może przyspieszyć wczytywanie strony.
Wadą SSG jest konieczność aktualizowania wygenerowanych plików po zmianie treści. Zazwyczaj wymaga to ponownego zbudowania serwisu. Rozwiązaniem jest inkrementalna regeneracja statyczna (ISR), która pozwala odświeżać wybrane podstrony bez przebudowy całej witryny. Dzięki temu zmienione treści mogą być publikowane na bieżąco, a pozostałe strony zachowują wcześniej wygenerowaną wersję.
Porównanie CSR, SSR i SSG
| Kryterium | CSR | SSR | SSG |
| Kto układa HTML? | przeglądarka użytkownika | serwer, przy każdym żądaniu | generator, podczas budowania serwisu |
| Treść w kodzie źródłowym | pusty kontener | pełna treść | pełna treść |
| Czas do pierwszego bajtu (TTFB) | bardzo niski | wyższy, zależny od obciążenia | najniższy |
| Czas do wyświetlenia treści (LCP) | wysoki, zależny od urządzenia | niski | najniższy |
| Aktualność danych | pełna, na żywo | pełna, na żywo | do ostatniej przebudowy |
| Koszt infrastruktury | niski | wysoki – serwer pracuje przy każdym żądaniu | bardzo niski |
| Treść widoczna dla robota pracującego na surowym HTML | wyłącznie pusty kontener | pełna treść | pełna treść |
| Sprawdza się przy | panele klienta, koszyk, konfiguratory | e-commerce, serwisy z danymi na żywo | blogi, landing page, dokumentacja |
Z punktu widzenia SEO istotne jest to, czy treść strony znajduje się już w kodzie HTML przesłanym przez serwer, czy pojawia się dopiero po wykonaniu JavaScriptu. W pierwszym przypadku Googlebot może ją odczytać bez dodatkowego renderowania, co ogranicza ryzyko problemów z indeksowaniem.
Wiele serwisów łączy różne sposoby renderowania w zależności od przeznaczenia podstron.
- SSG sprawdza się na blogach, stronach ofertowych i w dokumentacji, gdzie treści zmieniają się stosunkowo rzadko.
- SSR warto rozważyć w sklepach internetowych, szczególnie na stronach produktów, których ceny i dostępność często się zmieniają.
- CSR może być dobrym rozwiązaniem dla paneli klienta i koszyków zakupowych, ponieważ umożliwia sprawną obsługę interakcji.
Takie podstrony zazwyczaj nie powinny pojawiać się w wynikach wyszukiwania, dlatego często wyłącza się je z indeksowania za pomocą dyrektywy noindex.
Jakie problemy z renderowaniem strony występują w Google i jak je rozwiązać?
1. Treść strony pojawia się dopiero po wykonaniu skryptów
Strona trafia do kolejki renderowania, więc jej treść czeka na indeksowanie dłużej niż treść zwykłego dokumentu.
Rozwiązanie: przenieś do kodu źródłowego wszystko, co ma zajmować pozycje w wynikach: nagłówki, opisy, parametry, treść artykułu. Filtry, karuzele i widgety opinii mogą doładowywać się później.
2. Znaczniki sterujące indeksowaniem wstrzykiwane przez JavaScript
Tytuł, opis, znacznik canonical, atrybut hreflang i dyrektywa noindex dodawane skryptem to źródło trudnych do wykrycia błędów. Najwięcej kosztuje noindex obecny w kodzie źródłowym i usuwany później przez skrypt: Googlebot odczytuje go jeszcze przed renderowaniem i pomija stronę przy indeksowaniu [1].
Rozwiązanie: te znaczniki umieszczaj w odpowiedzi serwera.
3. Zablokowane pliki strony w robots.txt
Plik robots.txt mówi robotom, do których katalogów mają dostęp. Zablokowany katalog ze skryptami albo stylami oznacza, że WRS złoży stronę z samych dostępnych plików: moduł z opisem produktu zostanie pusty, a strona straci układ oceniany przy indeksowaniu.
Rozwiązanie: odblokuj katalogi z plikami JS, CSS, czcionkami i obrazami, a listę zasobów sprawdź w Search Console.
4. Nawigacja ukryta przed robotem
Googlebot zbiera adresy podstron z atrybutów href, a w elementach div z obsługą kliknięcia adres docelowy zostaje w skrypcie. Podobnie działają adresy z krzyżykiem, typu example.com/#/produkty: pochodzą ze schematu AJAX wycofanego w 2015 roku, więc dla Googlebota to jeden adres [2].
Rozwiązanie: każdy link buduj jako znacznik a z atrybutem href, a każdy widok publikuj pod osobnym adresem.
5. Miękkie błędy 404
O usuniętym zasobie serwer informuje kodem 404. Aplikacja jednostronicowa często oddaje kod 200, czyli potwierdzenie poprawnego wczytania, a komunikat o usuniętym produkcie wypisuje skrypt, więc pusta podstrona trafia do indeksu [2].
Rozwiązanie: przekieruj do adresu zwracającego status 404 albo dodaj dyrektywę noindex.
6. Treść strony ukryta za interakcją
Zakładki i przyciski „pokaż więcej” doładowują treść po kliknięciu, a więc po zakończeniu renderowania.
Rozwiązanie: umieszczaj treść wszystkich zakładek w kodzie od razu, a nieaktywne ukrywaj regułą CSS display: none – taką treść Google indeksuje, bo stoi w gotowym dokumencie. Przy listach produktów udostępniaj paginację z linkami.
Niech każda linijka kodu pracuje na Twoją widoczność!
7. Roboty AI pracują na surowym kodzie HTML
Analiza przeprowadzona przez Vercel i MERJ w grudniu 2024 roku wykazała, że roboty GPTBot (OpenAI), ClaudeBot (Anthropic) i PerplexityBot pobierały pliki JavaScript, ale ich nie wykonywały. Inaczej działa infrastruktura Google, z której korzysta Gemini i która umożliwia renderowanie stron [5]. Oznacza to, że strona może być prawidłowo indeksowana przez Google, a jednocześnie część jej treści może pozostawać niedostępna dla innych robotów AI.
Rozwiązanie: zastosuj renderowanie po stronie serwera (SSR) lub generowanie statyczne (SSG), aby nagłówki, opisy produktów, artykuły i linki znajdowały się już w kodzie HTML przesyłanym przez serwer. Dzięki temu roboty mogą odczytać te informacje bez konieczności wykonywania JavaScriptu.
Jak renderowanie strony wpływa na Core Web Vitals?
Core Web Vitals to trzy wskaźniki, którymi Google mierzy jakość wczytywania strony u rzeczywistych użytkowników, a model renderowania wpływa na każdy z nich, bo wyznacza, ile pracy przypada na urządzenie. Dane pochodzą z raportu CrUX (Chrome User Experience Report), zbieranego od użytkowników Chrome przez 28 dni, a próg „dobrego” wyniku musi osiągnąć 75 procent wizyt [6]:
- LCP (Largest Contentful Paint), czyli moment wyświetlenia największego elementu treści – co najwyżej 2,5 sekundy. Przy CSR przesuwa go czas pobrania i wykonania paczki JavaScriptu oraz czas odpowiedzi serwera z danymi, a różnica rośnie na słabszych telefonach.
- INP (Interaction to Next Paint), czyli czas od kliknięcia do kolejnego odrysowania strony – co najwyżej 200 milisekund. Największym zagrożeniem jest hydracja: dokument się wyświetlił, użytkownik klika, a główny wątek przeglądarki wciąż podpina obsługę zdarzeń.
- CLS (Cumulative Layout Shift), czyli stabilność układu – co najwyżej 0,1. Banery dostawiane po pierwszym wyświetleniu przesuwają treść pod palcem użytkownika. Układ zostaje stabilny, gdy obrazy i kontenery mają z góry podane wymiary.
SSR poprawia LCP, przenosząc obciążenie na TTFB, który wyznacza dolną granicę pozostałych wyników. SSG wypada najkorzystniej, o ile pliki strony stoją w sieci CDN.
Jak sprawdzić renderowanie strony w Google Search Console?
Renderowanie pojedynczej podstrony sprawdzisz narzędziem do sprawdzania adresów URL (URL Inspection) w Google Search Console. Raport pokazuje dokument w postaci, jaka powstaje po wykonaniu JavaScriptu, czyli dokładnie to, co Google bierze do indeksowania.
Wklej adres podstrony w pole u góry Search Console i wybierz jedną z dwóch ścieżek. Opcja „Wyświetl zindeksowaną stronę” przedstawia stan z ostatniego pobrania przez Google, a „Testuj aktywny adres URL” razem z „Wyświetl przetestowaną stronę” uruchamia renderowanie na żywo [7]. Test na żywo ma inny budżet czasu niż renderowanie przy indeksowaniu, więc wersja zindeksowana bywa uboższa.
Raport ma cztery sekcje:
- Zakładka HTML zawiera gotowy dokument po wykonaniu skryptów. Użyj wyszukiwania w oknie raportu (Ctrl+F, a na macOS Cmd+F) i sprawdź, czy stoi w nim Twój nagłówek, opis produktu i treść artykułu.
- Zakładka Zrzut ekranu działa wyłącznie w teście na żywo i obejmuje górną część strony, więc traktuj ją pomocniczo.
- Sekcja Zasoby strony wylicza pliki z informacją, które z nich zostały wczytane, a które zablokowane.
- Komunikaty konsoli JavaScript pojawiają się wyłącznie w teście na żywo i ujawniają błędy, które przerwały wykonywanie skryptów.
Search Console pokazuje stan pojedynczego adresu. Skalę zjawiska w serwisie ustalisz crawlerem: w Screaming Frogu przełącz tryb pobierania na JavaScript i włącz zapis obu wersji kodu, a raport porówna je dla każdego adresu. Logi serwera, filtrowane po nazwie robota w polu user-agent (Googlebot, GPTBot, ClaudeBot), pokażą, które adresy roboty odwiedzają i jakie kody odpowiedzi dostają.
Podsumowanie
Renderowanie strony internetowej wyznacza moment, w którym jej treść staje się dostępna – dla użytkownika, dla Googlebota i dla robotów zasilających modele językowe. Google wykonuje JavaScript w osobnym, opóźnionym etapie, a każda zależność treści od skryptów zwiększa ryzyko jej pominięcia. Treść i znaczniki do indeksowania umieszczaj więc w kodzie źródłowym, a JavaScript zostaw tam, gdzie obsługuje interakcję.
Zacznij od diagnozy: sprawdź w Google Search Console podstronę o najwyższym ruchu z wyszukiwarki, porównaj jej kod źródłowy z gotowym dokumentem i policz, ile treści pojawia się dopiero po wykonaniu skryptów. Ta informacja może wystarczyć, aby ustalić, czy trzeba zmienić model renderowania, czy wystarczą poprawki. Jeżeli wynik budzi wątpliwości, specjaliści Harbingers sprawdzą renderowanie całego serwisu w ramach audytu technicznego SEO.
FAQ
-
Co to jest renderowanie strony internetowej?
Renderowanie to proces przekształcania kodu HTML, CSS i JavaScript w stronę widoczną na ekranie. Obejmuje tworzenie struktury dokumentu, obliczanie układu elementów i wyświetlanie ich w przeglądarce.
-
Jak renderowanie strony wpływa na SEO?
Sposób renderowania decyduje o tym, kiedy i w jakiej postaci treści stają się dostępne dla robotów wyszukiwarek. Jeśli ważne informacje pojawiają się dopiero po wykonaniu JavaScriptu, ich odkrywanie i indeksowanie może być utrudnione.
-
Czym różni się CSR od SSR?
CSR (Client-Side Rendering) polega na tworzeniu treści strony w przeglądarce użytkownika za pomocą JavaScriptu. SSR (Server-Side Rendering) generuje gotowy HTML na serwerze, dzięki czemu roboty mogą odczytać treść bez wykonywania skryptów.
-
Jak poprawić renderowanie strony pod SEO?
Zadbaj o obecność ważnych treści w kodzie HTML, poprawne znaczniki indeksowania, dostępność plików JavaScript i CSS oraz linki z atrybutem
href. Następnie sprawdź efekty w Google Search Console i przeprowadź audyt techniczny SEO.
Źródła:
[1] https://developers.google.com
[2] https://developers.google.com
[3] https://developers.google.com
[4] https://developers.google.com
[5] https://vercel.com
[6] https://web.dev
[7] https://support.google.com