Retrieval-augmented generation – jak dziala RAG?
Model AI może świetnie formułować odpowiedzi, a jednocześnie nie znać najnowszej wersji cennika, procedury obowiązującej w Twojej firmie czy szczegółów konkretnej oferty. RAG – retrieval augmented generation pozwala uzupełnić tę lukę: przed wygenerowaniem odpowiedzi system wyszukuje potrzebne informacje w zewnętrznej bazie wiedzy i przekazuje je modelowi jako kontekst. Jak działa RAG, z czego składa się jego architektura i co zmienia agentic RAG?
Spis treści
- Co to jest RAG i po co łączyć LLM z bazą wiedzy?
- Jak działa RAG? Retriever, generator, embeddingi i baza wektorowa
- RAG a halucynacje AI – czy problem znika?
- RAG vs fine tuning i prompt engineering – trzy różne problemy
- Agentic RAG – co zmienia się w 2026 roku?
- GraphRAG – co to jest i kiedy przydaje się graf wiedzy?
- RAG – przykłady zastosowań w firmie
- Jak zbudować system RAG? Prosty schemat krok po kroku
Co to jest RAG i po co łączyć LLM z bazą wiedzy?
Duży model językowy nie działa jak firmowa baza danych. Jeśli potrzebuje informacji, których nie zna albo które zmieniły się po treningu, może odpowiedzieć nieprecyzyjnie lub je wymyślić.
Tu pojawia się RAG. Retrieval augmented generation po polsku można tłumaczyć jako generowanie wspomagane wyszukiwaniem. Zamiast polegać wyłącznie na wiedzy zapisanej w parametrach modelu, system przed odpowiedzią sięga do wskazanego źródła: dokumentacji, bazy produktów, regulaminów, instrukcji, CRM-u czy innego repozytorium danych. Znalezione fragmenty trafiają następnie do LLM, który wykorzystuje je jako kontekst.
Dzięki temu wiedzę można aktualizować bez ponownego trenowania całego modelu, a odpowiedź może opierać się na danych organizacji, których LLM nie miał w swoim zbiorze treningowym.
Chcesz, żeby AI korzystało z wiedzy Twojej firmy, a nie tylko z ogólnych danych modelu?
Jak działa RAG? Retriever, generator, embeddingi i baza wektorowa
Najprostsza architektura RAG ma dwa główne elementy: retriever, który wyszukuje informacje, oraz generator, czyli najczęściej LLM tworzący końcową odpowiedź.
Dokumenty zwykle dzieli się wcześniej na mniejsze fragmenty, czyli chunki. Model embeddingowy zamienia ich treść na reprezentacje liczbowe – embeddingi. Dzięki nim system może porównywać znaczenie zapytania użytkownika z treścią dokumentów, a nie tylko szukać identycznych słów.
Właśnie tutaj pojawia się baza wektorowa RAG. Może przechowywać embeddingi wraz z odpowiadającymi im fragmentami tekstu i metadanymi. Gdy użytkownik zada pytanie, retriever wyszukuje najbardziej zbliżone semantycznie fragmenty i przekazuje je wraz z pytaniem do modelu.
RAG – architektura w podstawowym wariancie wygląda więc tak:
pytanie użytkownika → wyszukanie informacji → wybór kontekstu → przekazanie go do LLM → wygenerowanie odpowiedzi.
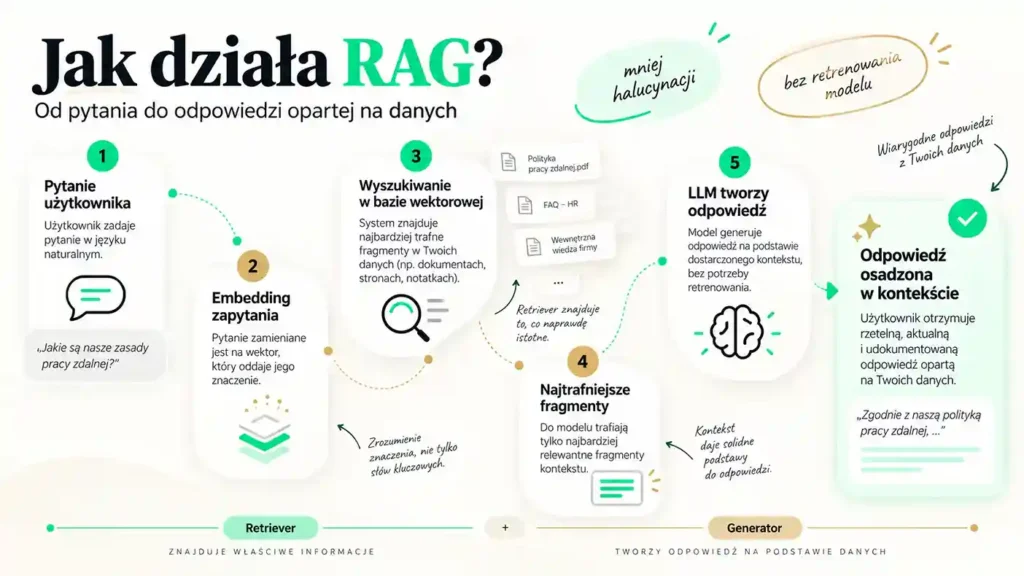
Grafika 1. Jak działa RAG? Schemat procesu wyszukiwania i generowania odpowiedzi. Źródło: opracowanie własne z wykorzystaniem narzędzi AI.
RAG a halucynacje AI – czy problem znika?
Jedną z największych zalet RAG jest grounding, czyli zakotwiczenie odpowiedzi w konkretnych źródłach. Jeśli model otrzymuje aktualny regulamin, kartę produktu czy procedurę zamiast odpowiadać wyłącznie z pamięci, ryzyko halucynacji AI może się zmniejszyć.
Nie znika jednak całkowicie. System może pobrać niewłaściwy fragment, dokument może być nieaktualny, a LLM może błędnie zinterpretować poprawnie znalezioną informację. Dlatego jakość RAG zależy także od danych, sposobu dzielenia dokumentów, wyszukiwania i reguł odpowiedzi, gdy źródła nie wystarczają.
RAG vs fine tuning i prompt engineering – trzy różne problemy
RAG, fine tuning i prompt engineering rozwiązują inne problemy. Prompt engineering zmienia instrukcję dla modelu, RAG dostarcza wiedzę potrzebną w konkretnym zapytaniu, a fine tuning dostraja parametry modelu na przygotowanych przykładach.
Jeśli więc problem brzmi „model nie zna naszego aktualnego regulaminu”, RAG zwykle odpowiada na niego lepiej niż fine tuning. Jeśli trzeba konsekwentnie zmienić sposób wykonywania powtarzalnego zadania, dostrajanie może mieć większy sens. Oba podejścia mogą też działać razem.
Szerzej różnice omawialiśmy w tekście Google AI Studio – jak zbudować własne narzędzie AI, dlatego tutaj nie będziemy ich powielać.
Agata Grabowska Senior Content Marketing Specialist w Harbingers
W praktyce skuteczność RAG zależy często mniej od tego, jaki model językowy wybierzemy, a bardziej od tego, jak przygotujemy i uporządkujemy wiedzę, z której ma korzystać. Nawet bardzo dobry LLM nie stworzy wiarygodnej odpowiedzi, jeśli system pobierze nieaktualny dokument, niewłaściwy fragment albo kilka sprzecznych źródeł. Dlatego coraz ważniejszym elementem projektów RAG stają się jakość danych, metadane, reguły aktualizacji i mechanizmy oceny retrievalu. Agentic RAG dodatkowo przesuwa ciężar z prostego „wyszukaj i odpowiedz” na system, który potrafi zdecydować, kiedy potrzebuje kolejnego źródła, dodatkowego kroku lub weryfikacji informacji. To właśnie w tym kierunku będą rozwijać się najbardziej użyteczne biznesowo rozwiązania AI.
Agentic RAG – co zmienia się w 2026 roku?
Klasyczny RAG często działa według z góry ustalonego schematu: dostaje pytanie, wykonuje wyszukiwanie, pobiera kilka fragmentów i przekazuje je do modelu. Agentic RAG idzie krok dalej. Model lub agent może sam decydować, czy potrzebuje dodatkowych informacji, czego powinien poszukać i czy po pierwszym wyszukaniu trzeba wykonać kolejne.
Ma to znaczenie szczególnie przy pytaniach wieloetapowych. Dobrym przykładem kierunku rozwoju jest opublikowany w lutym 2026 roku framework A-RAG. Badacze udostępnili modelowi hierarchiczne interfejsy retrieval obejmujące wyszukiwanie słów kluczowych, wyszukiwanie semantyczne i odczyt wybranych fragmentów. Zamiast realizować jeden sztywny workflow, agent może dobierać kolejne działania do konkretnego zapytania.
To przesuwa RAG od prostego „wyszukaj i odpowiedz” w stronę systemu, który potrafi zaplanować własną ścieżkę dochodzenia do informacji.
GraphRAG – co to jest i kiedy przydaje się graf wiedzy?
Nie każde pytanie da się dobrze obsłużyć przez wyszukanie kilku podobnych fragmentów. Czasem potrzebne jest zrozumienie relacji między osobami, produktami, zdarzeniami czy dokumentami.
GraphRAG łączy retrieval z grafem wiedzy, w którym informacje reprezentowane są jako encje i relacje między nimi. Podejście rozwijane m.in. przez Microsoft Research pozwala budować strukturę wiedzy na podstawie nieustrukturyzowanych dokumentów i tworzyć podsumowania na różnych poziomach. Dzięki temu może lepiej radzić sobie z pytaniami wymagającymi syntezy informacji rozproszonych w dużym zbiorze.
GraphRAG nie zastępuje klasycznego RAG w każdym projekcie. Przydaje się tam, gdzie ważne są zależności i szerszy kontekst.
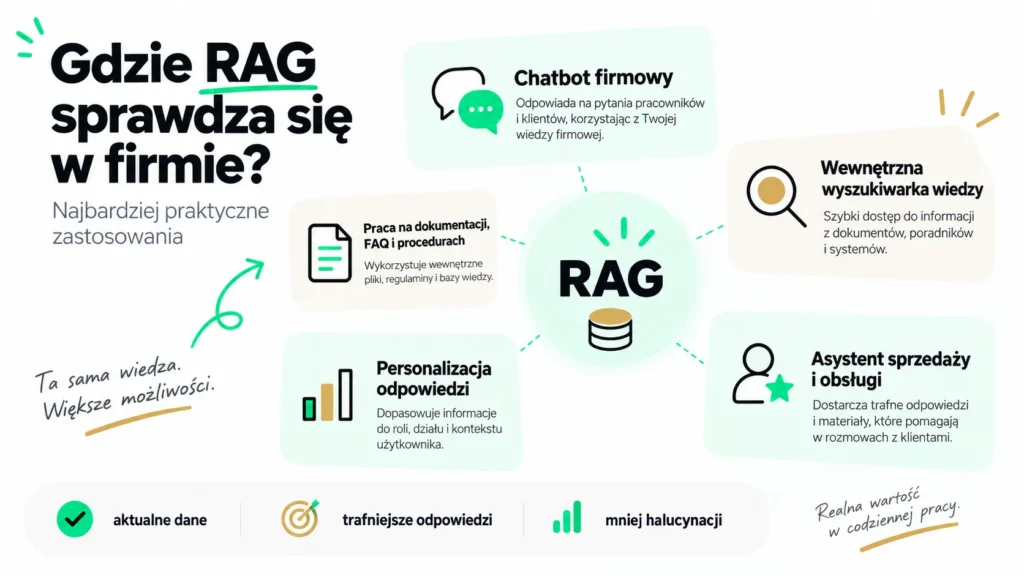
Grafika 2. Zastosowania RAG w firmie. Źródło: opracowanie własne z wykorzystaniem narzędzi AI.
RAG – przykłady zastosowań w firmie
RAG ma największy sens tam, gdzie odpowiedź powinna wynikać z konkretnej, kontrolowanej wiedzy. Może zasilać m.in.:
- chatbot RAG dla firmy – odpowiadający klientom na podstawie instrukcji, regulaminów, FAQ czy aktualnej oferty;
- wewnętrzną wyszukiwarkę wiedzy – pomagającą pracownikom znajdować informacje w procedurach i dokumentacji;
- asystenta sprzedaży – korzystającego z kart produktów, cenników i materiałów handlowych;
- personalizowane odpowiedzi – łączące wiedzę bazową z informacjami dotyczącymi konkretnego klienta;
- narzędzia dla marketingu – np. asystentów korzystających z guideline’ów marki, opisów produktów i repozytorium zaakceptowanych materiałów.
Jeśli interesują Cię także inne narzędzia AI przydatne w marketingu – nasze TOP 7, warto patrzeć na RAG nie jak na kolejną aplikację, ale jak na warstwę, którą można dołożyć do konkretnych procesów. Z kolei rozwój modeli, takich jak te tworzone przez Moonshot AI – co musisz wiedzieć, przypomina, że sam wybór LLM jest tylko jednym elementem systemu.
Chcesz wykorzystać firmową wiedzę w narzędziach AI?
Połącz dane, model i automatyzacje w rozwiązanie, które odpowiada na potrzeby Twojego biznesu.
Jak zbudować system RAG? Prosty schemat krok po kroku
Załóżmy, że firma chce stworzyć chatbota dla działu obsługi klienta na podstawie własnej dokumentacji.
- Zbiera i porządkuje źródła – np. FAQ, regulaminy, instrukcje, cenniki i procedury.
- Dzieli dokumenty na fragmenty i tworzy dla nich embeddingi.
- Zapisuje je w bazie wraz z metadanymi, np. datą obowiązywania dokumentu.
- Użytkownik zadaje pytanie, np. „Czy mogę zmienić termin dostawy po opłaceniu zamówienia?”.
- Retriever wyszukuje odpowiednie fragmenty dokumentacji.
- LLM otrzymuje pytanie i kontekst oraz generuje odpowiedź zgodną z firmowymi zasadami.
- Bardziej zaawansowany system może podać źródło, sprawdzić kolejny dokument albo odmówić odpowiedzi, jeśli baza nie zawiera wystarczających informacji.
Dzięki temu zmiana procedury nie musi oznaczać ponownego trenowania modelu. W wielu przypadkach wystarczy zaktualizować dokument i ponownie go zindeksować.
RAG – retrieval augmented generation dobrze pokazuje, że praktyczne wdrożenie AI nie musi polegać na stworzeniu modelu, który „wie wszystko”. Często ważniejsze jest zbudowanie systemu, który wie, gdzie szukać, kiedy potrzebuje danych i jak wykorzystać je do odpowiedzi. To znacznie bliżej realnych potrzeb organizacji, które zastanawiają się, jak zostać innowacyjną firmą dzięki AI, niż kolejny chatbot działający wyłącznie na ogólnej wiedzy modelu.
FAQ
-
Co to jest RAG?
RAG to metoda, która łączy model językowy z zewnętrzną bazą wiedzy. Dzięki temu AI może korzystać z aktualnych i firmowych danych podczas generowania odpowiedzi.
-
Jak działa RAG?
System najpierw wyszukuje informacje związane z pytaniem użytkownika, a następnie przekazuje je modelowi językowemu jako dodatkowy kontekst do stworzenia odpowiedzi.
-
Czy RAG eliminuje halucynacje AI?
Nie całkowicie, ale może znacząco ograniczyć ich ryzyko, ponieważ model opiera odpowiedź na konkretnych źródłach zamiast wyłącznie na wiedzy zapisanej w modelu.
-
Czym różni się RAG od fine tuningu?
RAG dostarcza modelowi dodatkową wiedzę w momencie zapytania, natomiast fine tuning zmienia sposób działania modelu poprzez dalsze trenowanie go na określonych danych.
Źródła:
cloud.google.com
docs.aws.amazon.com
cloud.google.com
arxiv.org